
1.9 KiB
Notes du cours de Big data d'openclassrooms / Calcul distribué - Data architect
Calcul distribué
Hello world du calcul distribué: Comptage de mots
MapReduce
Les opérations de calcul distribué peuvent se résumer en une combinaison des opérations de bases map et reduce. MapReduce s'inspire fortement du paradigme informatique "Divisez pour régner". Les données sont représentés sous la forme de paries (clé, valeur)
- Split: l'ensemble des données est découpé en sous-ensembles
- Map: transforme une liste de paires en une autre liste de paries
- Shuffle & Sort: regroupement et tri
- Reduce: Aggrégation, renvoie pour chaque clé une valeur unique

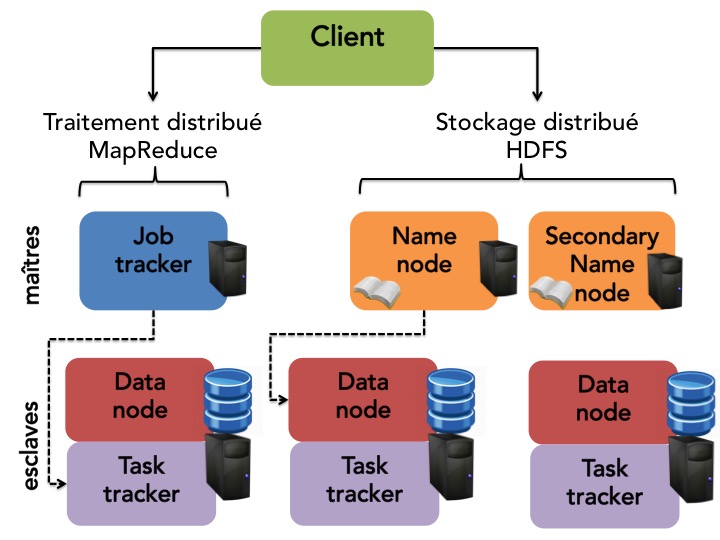
Organisation des clusters en architecture maître-client.
Un cluster est composé d'un ensemble de noeud. Chacun de ces noeud a un rôle. Le client s'adresse au noeud maitre qui relègue la tâche au noeud esclaves qui servent d'exécuteurs.
Traitement distribué
Un noeud maitre qui fait office de job tracker et plusieurs noeuds esclaves.
Stockage distribué
Un noeud maitre qui sert de noeud de nom accompagné parfois qu'un noeud de nom secondaire, ainsi que plusieurs noeuds esclaves qui stockent les données et les tâches.
Hadoop et Spark
Les implémentations connues sont Apache Hadoop et Apache Spark. Spark est 100x supérieure à Hadoop en vitesse car les données sont conservées dans la RAM lors de l'éxécution.
YARN Gestionnaire de cluster
SparkUI
SparkML
AWS
Services principaux
- EC2: Elastic Compute Cloud
- EMR: Elastic MapReduce
- S3: Simple Storage Service
AWS-CLI
- Installation
pip install awscli
- Création de compte aws
- Création de clé ssh
Supervision des logs
logs d'EMR sur S3
cloud watch outil de supervision fourni par aws